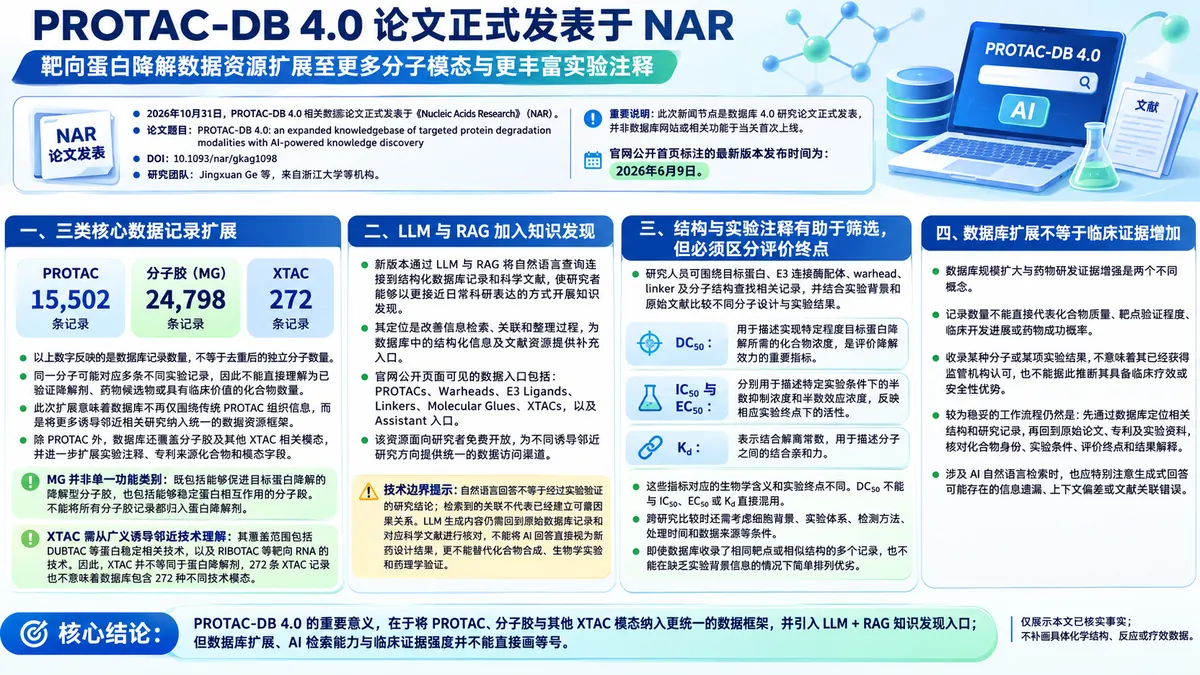
靶向蛋白降解领域的数据资源正在向更多分子模态和更丰富的实验注释扩展。2026年10月31日,PROTAC-DB 4.0相关数据库论文正式发表于《Nucleic Acids Research》(NAR),论文题为PROTAC-DB 4.0: an expanded knowledgebase of targeted protein degradation modalities with AI-powered knowledge discovery,DOI为10.1093/nar/gkag1098。
该研究由Jingxuan Ge等研究人员参与完成,来自浙江大学等机构的研究团队对PROTAC-DB进行了扩展,进一步纳入分子胶(Molecular Glues,MG)和其他功能性靶向嵌合体(X-functional targeting chimeras,XTAC)相关数据,同时引入基于大语言模型(LLM)和检索增强生成(RAG)的自然语言知识发现功能。
需要区分的是,此次新闻节点是数据库4.0研究论文正式发表,并非数据库网站或相关功能于当天首次上线。PROTAC-DB官网公开首页标注的最新版本发布时间为2026年6月9日。
一、三类核心数据记录扩展,覆盖更多诱导邻近模态
- PROTAC:15,502条记录,围绕蛋白降解靶向嵌合体及其相关实验信息。
- 分子胶(MG):24,798条记录,进一步扩展对分子胶相关化合物及实验信息的收录。
- XTAC:272条记录,纳入其他功能性靶向嵌合体及相关诱导邻近技术。
这些数字反映的是数据库中的记录数量,而不是经过去重后的独立分子数量,也不能直接理解为已验证降解剂、药物候选物或具有临床价值的化合物数量。同一分子可能对应多条不同实验记录,因此记录数量与独立化合物数量并不等价。
此次扩展的一个重要变化,是数据库不再仅围绕传统PROTAC分子组织信息,而是将更多诱导邻近相关研究纳入统一的数据资源框架。除PROTAC外,数据库还覆盖分子胶及其他XTAC相关模态,并进一步扩展实验注释、专利来源化合物和模态字段。
其中,分子胶并非单一功能类别。MG记录既包括能够促进目标蛋白降解的降解型分子胶,也包括能够稳定蛋白相互作用的分子胶。两者的生物学结果和研究目的可能不同,不能将所有分子胶记录都归入蛋白降解剂。
XTAC同样需要从广义诱导邻近技术的角度理解。其覆盖范围包括DUBTAC等蛋白稳定相关技术,以及RIBOTAC等靶向RNA的技术。因此,XTAC并不等同于蛋白降解剂,272条XTAC记录也不意味着数据库包含272种不同的技术模态。
二、LLM与RAG加入知识发现,补充传统数据库检索
新版本通过LLM与RAG将自然语言查询连接到结构化数据库记录和科学文献,使研究者能够通过更接近日常科研表达的方式开展知识发现。其定位是改善信息检索、关联和整理过程,为数据库中的结构化信息及文献资源提供补充入口。
这一功能值得关注,但需要明确其技术边界。自然语言回答不等于经过实验验证的研究结论,检索到的关联也不代表已经建立了可靠的因果关系。LLM生成的内容仍然需要回到原始数据库记录和对应科学文献进行核对,不能将AI回答直接视为新药设计结果,更不能替代化合物合成、生物学实验和药理学验证。
从官网公开页面可以看到,PROTAC-DB提供PROTACs、Warheads、E3 Ligands、Linkers、Molecular Glues和XTACs等数据入口,同时设置Assistant入口。该资源面向研究者免费开放,为不同诱导邻近研究方向提供统一的数据访问渠道。
三、结构与实验注释有助于筛选,但必须区分评价终点
在实际使用中,研究人员可以围绕目标蛋白、E3连接酶配体、warhead、linker以及分子结构等信息查找相关记录,再结合实验背景和原始文献,比较不同分子设计与实验结果。这些信息也能够为后续的数据整理、候选结构筛选和计算建模提供基础。
- DC50:用于描述实现特定程度目标蛋白降解所需的化合物浓度,是评价降解效力的重要指标。
- IC50与EC50:分别用于描述特定实验条件下的半数抑制浓度和半数效应浓度,反映相应实验终点下的活性。
- Kd:表示结合解离常数,用于描述分子之间的结合亲和力。
这些指标对应的生物学含义和实验终点不同。DC50不能与IC50、EC50或Kd直接混用,跨研究比较时还需要考虑细胞背景、实验体系、检测方法、处理时间和数据来源等条件。即使数据库收录了相同靶点或相似结构的多个记录,也不能在缺乏实验背景信息的情况下简单排列优劣。
四、数据库扩展不等于临床证据增加
但数据库规模扩大与药物研发证据增强是两个不同概念。记录数量不能直接代表化合物质量、靶点验证程度、临床开发进展或药物成功概率。收录某种分子或某项实验结果,也不意味着其已经获得监管机构认可,更不能据此推断其具备临床疗效或安全性优势。
对于实际使用者,较为稳妥的工作流程仍然是先通过数据库定位相关结构和研究记录,再回到原始论文、专利及实验资料,核对化合物身份、实验条件、评价终点和结果解释。涉及AI自然语言检索时,也应特别注意生成式回答可能存在的信息遗漏、上下文偏差或文献关联错误。
配图说明:AI生成配图,仅用于辅助呈现文章主题。分子与检索界面图标为概念示意,不是已验证化合物结构或数据库实际界面截图。 配图仅为AI主题示意,不是论文原图或实验数据。